

Het officiële Nederlandse beoordelingssysteem voor tests kent geen criterium dat „validiteit“ heet. In plaats daarvan staan er twee afzonderlijke criteria in de lijst, elk met een eigen cijfer. Dat zegt iets over hoe je validiteit in een scriptie aanpakt.
Validiteit is de geldigheid van een meting: een vragenlijst of toets is valide wanneer die het kenmerk meet dat in je onderzoeksvraag staat en niet, zonder dat iemand het merkt, een ander kenmerk, want alleen dan geven de resultaten antwoord op de vraag die je stelde. Na dit artikel weet je welke validiteit jouw onderzoek kan onderbouwen.
📌 In het kort
- Validiteit betekent dat de meting het bedoelde kenmerk raakt.
- Inhoud, criterium en begrip zijn de drie soorten.
- Er bestaat geen enkele coëfficiënt voor validiteit.
- Begripsvaliditeit en constructvaliditeit betekenen hetzelfde.
- De COTAN beoordeelt validiteit in twee aparte criteria.
Gratis enquête maken
Met empirio.ai maak je in enkele minuten een moderne online enquête — met hosting in de EU.
- Enquête met AI
- Aanpassen met drag & drop
- Analyse in realtime
Validiteit in één zin: het juiste meten
Validiteit geeft aan of een meting werkelijk het bedoelde kenmerk vastlegt. Het Centraal Bureau voor de Statistiek formuleert het kort in Vragenlijstontwikkeling: „Validiteit betekent dat ook daadwerkelijk het concept gemeten wordt dat de onderzoeker bedoeld heeft.“
Valide is het bijbehorende bijvoeglijk naamwoord. Een voorbeeld uit de collegezaal: een statistiektoets zou moeten weergeven wat studenten in het semester hebben geleerd. Komen de vragen uit een oud studieprogramma en past slechts een derde bij de behandelde stof, dan meet het cijfer vooral voorkennis. Zelfde toets, zelfde procedure, verkeerd kenmerk.
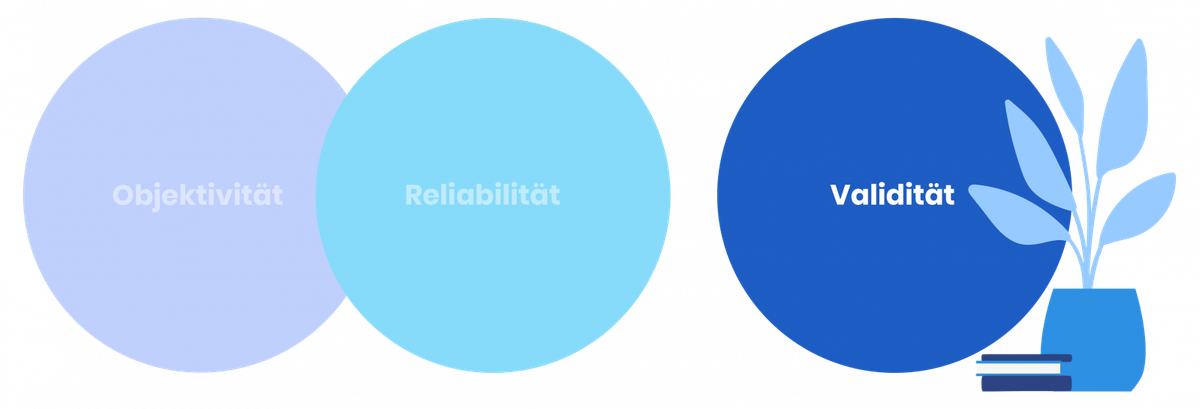
Validiteit veronderstelt betrouwbaarheid, en alleen in die richting. Moosbrugger en Kelava (2012) schrijven dat een test met lage betrouwbaarheid geen hoge validiteit kan hebben. Een nauwkeurige meting kan dus nog steeds naast het onderwerp meten, een onnauwkeurige meting wordt nooit geldig.
Let op
Begripsvaliditeit en constructvaliditeit zijn twee namen voor hetzelfde. Hugo Quené zet ze in het open leerboek van de Universiteit Utrecht uitdrukkelijk gelijk. In testcontexten is begripsvaliditeit de gangbare term, omdat de COTAN die gebruikt.
Hoe de COTAN testkwaliteit beoordeelt
De COTAN van het Nederlands Instituut van Psychologen beoordeelt psychodiagnostische instrumenten op zeven criteria, en validiteit is daarin opgesplitst. De lijst bestaat uit uitgangspunten van de testconstructie, kwaliteit van het testmateriaal, kwaliteit van de handleiding, normen, betrouwbaarheid, begripsvaliditeit en criteriumvaliditeit. Volgens het COTAN Beoordelingssysteem kan het oordeel per criterium „onvoldoende“, „voldoende“ of „goed“ zijn.
Twee dingen vallen daaraan op. Ten eerste bestaat er geen overkoepelend criterium validiteit, wat betekent dat begripsvaliditeit en criteriumvaliditeit los van elkaar worden beoordeeld. Ten tweede ontbreekt objectiviteit volledig, terwijl Duitstalige handboeken dat als een van drie hoofdcriteria voeren. In plaats daarvan staan er praktische criteria in de lijst, zoals de kwaliteit van de handleiding.
Inhoudsvaliditeit hoort trouwens niet bij de COTAN-criteria. Die term komt in Nederland vooral voor in de toetsdidactiek, bijvoorbeeld in het toetsmateriaal van de Universiteit van Amsterdam, waar inhoudsvaliditeit betekent dat de toets representatief is voor de gehele leerstof. Voor een scriptie is dat een prettige verdeling: inhoudsvaliditeit onderbouw je met argumenten, begrips- en criteriumvaliditeit met samenhangen.
Drie soorten validiteit en hoe je ze onderbouwt
Geen enkele procedure stelt validiteit alleen vast. Onderbouwing komt uit verschillende richtingen en de testtheorie ordent die in drie soorten. Het verschil zit in de maatstaf: de inhoud van het instrument, een criterium buiten de test of de theorie achter het kenmerk.
In een scriptie is de keuze snel gemaakt. Een onafhankelijk criterium buiten de test is zelden beschikbaar, dus dragen inhoudsvaliditeit en begripsvaliditeit het methodehoofdstuk. Beide onderbouw je met argumenten in plaats van met een berekening.
Inhoudsvaliditeit: dekt de vragenlijst het kenmerk?
Inhoudsvaliditeit geeft aan in hoeverre een test, of een los item, het te meten kenmerk representatief vastlegt. Hier reken je niets uit. De onderbouwing komt uit het vakinhoudelijke argument achter elk item en uit het oordeel van meerdere deskundigen over relevantie, representativiteit, nauwkeurigheid en helderheid.
Criteriumvaliditeit: kun je iets buiten de test concluderen?
Criteriumvaliditeit bestaat wanneer gedrag binnen de testsituatie een conclusie over een criterium daarbuiten toelaat. Ligt het criterium op hetzelfde moment, dan heet dat concurrente validiteit, ligt het in de toekomst, dan predictieve validiteit. Een selectietoets waarvan de score samenhangt met later studiesucces heeft predictieve validiteit. Een criterium is altijd een onafhankelijk gemeten kenmerk en nooit een tweede tekst over hetzelfde onderwerp.
Begripsvaliditeit: houdt de conclusie over het construct?
Begripsvaliditeit bestaat wanneer de stap van antwoordgedrag naar het onderliggende construct wetenschappelijk onderbouwd is. Quené omschrijft die als de mate waarin de operationalisatie van de variabelen een adequate afspiegeling is van wat je bedoelt. De onderbouwing loopt twee kanten op: hoge samenhang met instrumenten die hetzelfde meten en lage samenhang met instrumenten die bewust iets anders meten.
Sommige lijsten noemen vijf soorten en voegen expertvaliditeit en known-group-validiteit toe. Geen van beide is een eigen soort: het zijn manieren om de drie hierboven te onderbouwen. Een deskundigenoordeel ondersteunt de inhoudsvaliditeit, en een vergelijking met een groep waarvan het verschil vooraf bekend is ondersteunt de begripsvaliditeit. Zonder dat onderscheid belanden procedures en soorten in dezelfde opsomming.
Interne en externe validiteit: twee vragen over de opzet
Interne en externe validiteit beoordelen de onderzoeksopzet en niet het meetinstrument. Interne validiteit vraagt of een uitspraak over oorzaak en gevolg binnen het onderzoek houdt, dus of de onderzochte variabele het effect werkelijk veroorzaakte en niet een derde factor. Externe validiteit vraagt hoe ver de resultaten reiken, naar andere groepen mensen, andere situaties en andere momenten. Lydia Repke, Lukas Birkenmaier en Clemens M. Lechner scheiden beide in de GESIS Survey Guideline over validiteit (2024).
Interne en externe validiteit trekken in tegengestelde richtingen. De guideline merkt op dat onderzoekers gewoonlijk aannemen dat beide omgekeerd samenhangen, zonder dat die tegenstelling onvermijdelijk is. Een laboratoriumexperiment houdt storende invloeden buiten de deur en het dagelijks leven met hen. Een veldonderzoek laat het dagelijks leven binnen, met alle invloeden die niemand stuurt.
Bij een online onderzoek ligt de scheidslijn duidelijk. Externe validiteit rust op de steekproef, interne validiteit op de vraag of je alternatieve verklaringen kunt uitsluiten. Tachtig medestudenten ondervragen en daarna over alle studenten in Nederland schrijven is een bereikprobleem en geen vragenlijstprobleem. Het gekozen onderzoeksontwerp bepaalt dus welke van de twee vormen je kunt claimen.
Gratis enquête maken
Met empirio.ai maak je in enkele minuten een moderne online enquête — met hosting in de EU.
- Enquête met AI
- Aanpassen met drag & drop
- Analyse in realtime
Waarom er geen validiteitscoëfficiënt te rapporteren valt
De testtheorie kent geen tegenhanger van de betrouwbaarheidscoëfficiënt. Validiteit rapporteer je niet als getal in de resultaten, je beargumenteert die in het methodehoofdstuk, en slechts een deel van dat argument valt te berekenen. Zoeken naar het waardebereik van validiteit is zoeken naar een grootheid die nooit is gedefinieerd.
Het berekenbare deel is de criteriumvaliditeit, want die neemt de vorm aan van een samenhang tussen score en criterium. Voor het lezen van zulke correlaties geeft de GESIS Survey Guideline grove richtwaarden: klein (0,10), gemiddeld (0,30) en groot (0,50). Die getallen helpen bij het lezen en vormen geen drempel voor validiteit.
| Soort | Onderbouwing | Past wanneer |
|---|---|---|
| Inhoudsvaliditeit | vakinhoudelijk argument en deskundigenoordeel | in bijna elke scriptie |
| Begripsvaliditeit | samenhang met soortgelijke en afwijkende instrumenten | je bouwde de schaal zelf |
| Criteriumvaliditeit | samenhang met een onafhankelijk criterium | er bestaat een criterium buiten de test |
| Interne validiteit | uitsluiten van alternatieve verklaringen | er zijn experimenten of oorzaakvragen |
| Externe validiteit | steekproeftrekking en onderzoekssituatie | je doet uitspraken over een populatie |
Pas op
Zet geen validiteitswaarde in je scriptie die je zelf niet hebt berekend. In het eindgesprek verdedig je de methode en niet het getal: een beargumenteerde inhoudsvaliditeit plus een open benoemde grens van je steekproef weegt daar veel zwaarder dan een cijfer zonder procedure erachter.
Validiteit verhogen: wat je voor de dataverzameling beslist
Validiteit wordt beslist bij de operationalisatie, op het moment dat een abstract begrip concrete vragen wordt. Na de dataverzameling valt niets meer te repareren: een vraag die naast het kenmerk zit blijft ernaast zitten, hoeveel antwoorden er ook binnenkomen.
De meest effectieve stap is de pretest, en in Nederland is die zelfs voorgeschreven bij officiële statistiek. Het CBS noemt als minimumvereiste van Eurostat dat een nieuwe vragenlijst in ieder geval één keer met potentiële respondenten getest moet zijn. Vijf tot tien mensen uit je doelgroep vullen de vragenlijst in en vertellen daarna hoe ze elke vraag begrepen.
Twee verwarringen kosten met regelmaat punten. De eerste betreft Cronbachs alfa: een hoge waarde onderbouwt nauwkeurigheid en geen geldigheid, want een schaal kan volkomen homogeen zijn en toch sociale wenselijkheid meten in plaats van een echte houding. De tweede betreft het criterium: je eigen resultaten met de literatuur vergelijken toetst de plausibiliteit van je conclusies en niet de criteriumvaliditeit van je instrument.
Wat de geldigheid van je meting veiligstelt
- De hypothese staat voor de eerste vraag.
- Elke vraag hoort bij een dimensie van de onderzoeksvraag.
- Meerdere vragen raken hetzelfde kenmerk uit verschillende hoeken.
- Een pretest laat zien hoe je doelgroep de vragen leest.
- Deskundigen kijken de itemlijst na voordat je verstuurt.
- De grenzen van de steekproef staan in het methodehoofdstuk.
Conclusie
Van de kwaliteitscriteria lijkt validiteit het minst op statistiek en zegt die het meest over een onderzoek. Berekenen doe je haar niet, beargumenteren wel, en dat argument bouw je op tijdens het schrijven van de vragen. Wie de drie soorten scheidt en het bereik van de steekproef open benoemt, gaat rustig het eindgesprek in.
Geen getal onderbouwt validiteit. De opbouw van de vragen doet dat wel.
Hoe verder
- Wil je de drie criteria naast elkaar zien? Objectiviteit, betrouwbaarheid en validiteit vergeleken
- Zoek je de nauwkeurigheid van een meting? Wat betekent betrouwbaarheid?
- Zoek je het derde criterium? Wat betekent objectiviteit?
- Wil je je steekproef onderbouwen? Wanneer is een online onderzoek representatief?
- Wil je het hele proces zien? Empirisch onderzoek: definitie, methoden, gids
Onze leestip: voor de Nederlandse praktijk is Vragenlijstontwikkeling van Giesen, Meertens, Vis-Visschers en Beukenhorst (CBS, 2010) de beste ingang, met concrete testmethoden voor vragenlijsten. Voor de systematiek van de soorten is hoofdstuk 2 van Moosbrugger, Helfried en Kelava, Augustin (red.) (2012): Testtheorie und Fragebogenkonstruktion, 2e editie, Springer, gratis als fragment beschikbaar.
Wil je je vragen testen voordat de dataverzameling start?
Met empirio.ai, een online enquêtetool uit Duitsland, maak je je vragenlijst gratis en stuur je die eerst naar een paar mensen. De data staan voor 100 procent in de EU.