

„Wie zufrieden bist du mit deinem Studium?“ Darunter fünf Kästchen, links „sehr unzufrieden“, rechts „sehr zufrieden“. Diese Antwortform steckt in fast jedem Fragebogen und sie hat einen Namen: Ratingskala.
Eine Ratingskala ist ein abgestuftes Antwortformat, auf dem eine befragte Person angibt, wie stark ein Merkmal bei ihr ausgeprägt ist. Sie gibt mehrere Stufen zwischen zwei Enden vor, meist fünf bis sieben, und jede Stufe steht für eine Abstufung des subjektiven Empfindens. Nach diesem Artikel weißt du, wie viele Stufen deine Skala braucht, wie du sie beschriftest und welche Kennzahl am Ende in deine Auswertung darf.
📌 Das Wichtigste im Überblick
- Eine Ratingskala erfasst Abstufungen statt Ja-Nein-Antworten.
- Die GESIS Survey Guidelines empfehlen fünf bis sieben Stufen.
- Streng genommen misst eine Ratingskala auf Ordinalniveau.
- Vollständig beschriftete Stufen liefern meist bessere Daten.
- „Weiß nicht“ gehört nicht in die Skalenmitte.
Kostenlos Umfrage erstellen
Mit empirio.ai erstellst du in wenigen Minuten eine moderne Online-Umfrage – mit Hosting in der EU.
- Umfrage per KI
- Per Drag & Drop anpassen
- Auswertung in Echtzeit
Was ist eine Ratingskala?
Eine Ratingskala ist ein gebundenes Antwortformat mit mehreren abgestuften Kategorien, mit dem eine befragte Person einschätzt, wie stark ein Merkmal bei ihr ausgeprägt ist, zum Beispiel von „sehr unzufrieden“ bis „sehr zufrieden“. Das englische Wort rating bedeutet Bewertung oder Einschätzung. Im Deutschen findest du auch die Bezeichnungen Einschätzskala, Schätzskala und Bewertungsskala. Gemeint ist immer dasselbe.
Das Lexikon der Psychologie von Hogrefe beschreibt die Ratingskala als „eine abgestufte, mehrstufige Skala, oft mit etikettierten Kategorien, auf der der Befragte seine Antwort auf eine Frage ausdrücken soll“ (Dorsch, Stichwort Ratingskala). Genau darin liegt ihr Wert. Eine geschlossene Ja-Nein-Frage trennt nur zwei Gruppen, während eine Ratingskala abbildet, wie weit jemand zwischen den Polen steht. Innerhalb der Fragetypen im Fragebogen ist sie deshalb das Standardformat für Einstellungen, Zufriedenheit und Selbsteinschätzungen.
Ratingskalen kommen in zwei Rollen vor. Bei der Selbstbeurteilung schätzt eine Person sich selbst ein, etwa ihre eigene Nervosität vor Prüfungen. Bei der Fremdbeurteilung schätzt jemand anderes dieselbe Person oder ein Objekt ein, etwa eine Lehrkraft das Sozialverhalten einer Klasse. Die Skala sieht in beiden Fällen gleich aus, die Fehlerquellen unterscheiden sich aber deutlich.
Eine Ratingskala misst nicht, wie etwas ist, sondern wie es empfunden wird.
Noch eine Abgrenzung, weil sie beim Suchen ständig für Verwirrung sorgt: In der Finanzwelt bezeichnet „Ratingskala“ etwas ganz anderes, nämlich die Bonitätsstufen, mit denen Banken und Ratingagenturen Kreditrisiken einordnen. Dieser Artikel behandelt ausschließlich die Ratingskala als Antwortformat in einer Online-Befragung oder einem gedruckten Fragebogen.
Welches Skalenniveau hat eine Ratingskala?
Eine Ratingskala misst streng genommen auf Ordinalniveau. Die Stufen stehen in einer klaren Reihenfolge, aber es lässt sich nicht nachweisen, dass der Abstand zwischen „trifft wenig zu“ und „trifft teils-teils zu“ genauso groß ist wie der zwischen „trifft ziemlich zu“ und „trifft völlig zu“.
Die Methodenberatung der Universität Zürich formuliert es für Items einer Likert-Skala so: „Grundsätzlich müssten Antworten auf einer Likert-Skala als ordinalskaliert betrachtet werden, denn es kann nicht zwingend davon ausgegangen werden, dass die Teilnehmer einer Umfrage die Abstände zwischen den Antworten als gleich wahrnehmen.“ Und gleich danach: „Trotzdem werden solche Items in der Praxis oft als intervallskaliert behandelt, wenn die Annahme plausibel erscheint“ (Methodenberatung der Universität Zürich).
Deshalb findest du in Lehrbüchern zwei verschiedene Auskünfte. Das Lehrmaterial der TU Dresden hält fest, es sei „strittig, ob sie auf Ordinal- oder Intervallniveau messen“ (TU Dresden, Methoden der Psychologie). Für deine Arbeit lässt sich die Frage trotzdem pragmatisch beantworten, und zwar an einem Kriterium: Geht es um ein einzelnes Item oder um mehrere Items, die zu einem Gesamtwert verrechnet werden?
Ratingskala und Likert-Skala: wo der Unterschied liegt
Eine Likert-Skala ist eine bestimmte Bauform der Ratingskala und keine Alternative dazu. Kennzeichnend sind eine Zustimmungsdimension, mehrere Items zum selben Konstrukt und ein Summen- oder Mittelwert über alle Items. Ein einzelnes Item nennt die Methodenliteratur korrekter „Likert-Type-Item“ und genau dieses Item bleibt ordinalskaliert. Was die Bauform darüber hinaus verlangt, steht in unserem Beitrag zur Likert-Skala.
Ein Summenscore über mehrere Items wird in der Praxis dagegen meist wie eine Intervallskala ausgewertet. Nicht weil das Zusammenrechnen das Messniveau anheben würde, denn das tut es nicht. Der Grund ist, dass ein solcher Score viele Abstufungen hat und die gängigen Verfahren sich gegenüber dieser Verletzung als robust erwiesen haben. Eine Annahme bleibt es trotzdem.
Für den Methodenteil
Wer aus Antwortstufen einen Mittelwert bildet, schreibt einen Satz dazu: „Die Antwortstufen wurden als äquidistant behandelt.“ Dieser Satz kostet eine Zeile und nimmt der Prüfungskommission die Nachfrage vorweg. Ohne ihn behauptet die Auswertung ein Messniveau, das die Daten nicht hergeben.
Welche Arten von Ratingskalen gibt es?
Ratingskalen unterscheiden sich nicht nur in ihrer Länge, sondern entlang von drei Gestaltungsfragen: nach der Richtung, nach der Markierung der Stufen und nach der Feinheit der Antwort. Mit diesen drei Fragen lässt sich jede Skala beschreiben, die dir in einem Fragebogen begegnet.
Die Kombination entscheidet mit darüber, wie gut die Daten am Ende werden. Eine Skala mit zwei gegensätzlichen Polen und nur beschrifteten Enden stellt andere Anforderungen an die Befragten als eine Skala, deren fünf Stufen alle ein Wort tragen. Gehen wir die drei Fragen einzeln durch.
Unipolar oder bipolar: wie viele Richtungen die Ratingskala abbildet
Eine Vorwarnung gehört vor die Beispiele: Bei Zustimmungsskalen ist die Zuordnung in der Fachliteratur nicht einheitlich. Die GESIS Survey Guidelines halten ausdrücklich fest, es gebe „keine einheitliche Definition der Polarität in der Literatur“. Wer in einer Abschlussarbeit eine Skala als unipolar oder bipolar bezeichnet, schreibt deshalb besser dazu, welcher Definition er folgt.
Eine unipolare Ratingskala bildet die Intensität eines einzelnen Merkmals ab, von gar nicht bis sehr stark. Typische Fälle sind das Ausmaß einer Lärmbelästigung oder die Stärke von Schmerzen. Ein Beispiel: „Wie stark belasten dich die Bauarbeiten vor deinem Haus?“ mit den Stufen von „gar nicht“ bis „sehr stark“. Hier gibt es keinen Gegenpol, sondern nur mehr oder weniger von einer Sache.
Eine bipolare Ratingskala setzt zwei gegensätzliche Merkmale an die Enden, etwa unzufrieden und zufrieden oder angespannt und gelassen. Ein Beispiel: „Ich empfinde die Arbeitsatmosphäre in unserem Großraumbüro als …“, mit Stufen von „angespannt“ über die Mitte bis „gelassen“. Die beiden Pole definieren sich gegenseitig. Genau das macht die Bauform anspruchsvoll, denn die Mitte muss inhaltlich etwas bedeuten.
Verbal, numerisch, symbolisch oder grafisch: womit die Stufen markiert sind
Die Marken sind das, was die Befragten tatsächlich sehen. Die TU Dresden unterscheidet vier Formen und jede hat ihren Einsatzbereich.
| Form der Marke | So sieht sie aus | Wofür sie taugt |
|---|---|---|
| Verbal | ein Wort je Stufe | Standardfall, am wenigsten missverständlich |
| Numerisch | Zahlen, etwa 1 bis 6 | vertraute Systeme wie Schulnoten |
| Symbolisch | Smileys, Sterne, Daumen | Kinder, kurze Feedbackfragen |
| Grafisch | Punkt auf einer Strecke | feine Abstufungen online |
Numerische Marken wirken eindeutig, sind es aber nicht immer. Bei Schulnoten von 1 bis 6 weiß praktisch jede Person, die hier zur Schule gegangen ist, wo oben und unten liegt. Bei einer nackten Skala von 1 bis 7 ohne Worte muss sie raten und zwei Befragte legen dieselbe Zahl unterschiedlich aus. Der Net Promoter Score mit seiner Spanne von 0 bis 10 ist das bekannteste Beispiel für eine numerische Skala, bei der nur die Enden ein Wort tragen.
Diskret gestuft oder kontinuierlich: wie fein die Antwort ausfällt
Die allermeisten Ratingskalen sind diskret gestuft. Sie geben eine feste Zahl von Kästchen vor und dazwischen gibt es nichts. Das ist der Normalfall auf Papier wie am Bildschirm.
Kontinuierliche Ratingskalen arbeiten stattdessen mit einem Schieberegler oder einer Linie, auf der ein beliebiger Punkt gewählt wird. Das Forschungsmethoden-Wiki der RPTU Kaiserslautern-Landau führt diese Bauform als Slider Scale, bei der die Befragten „einen Regler auf einer kontinuierlichen Skala“ bewegen (RPTU, Forschungsmethoden-Wiki). In der Medizin heißt dieselbe Idee visuelle Analogskala und dient der Schmerzmessung. Sinnvoll ist sie fast nur online. Auf Papier müsste hinterher jemand mit dem Lineal nachmessen.
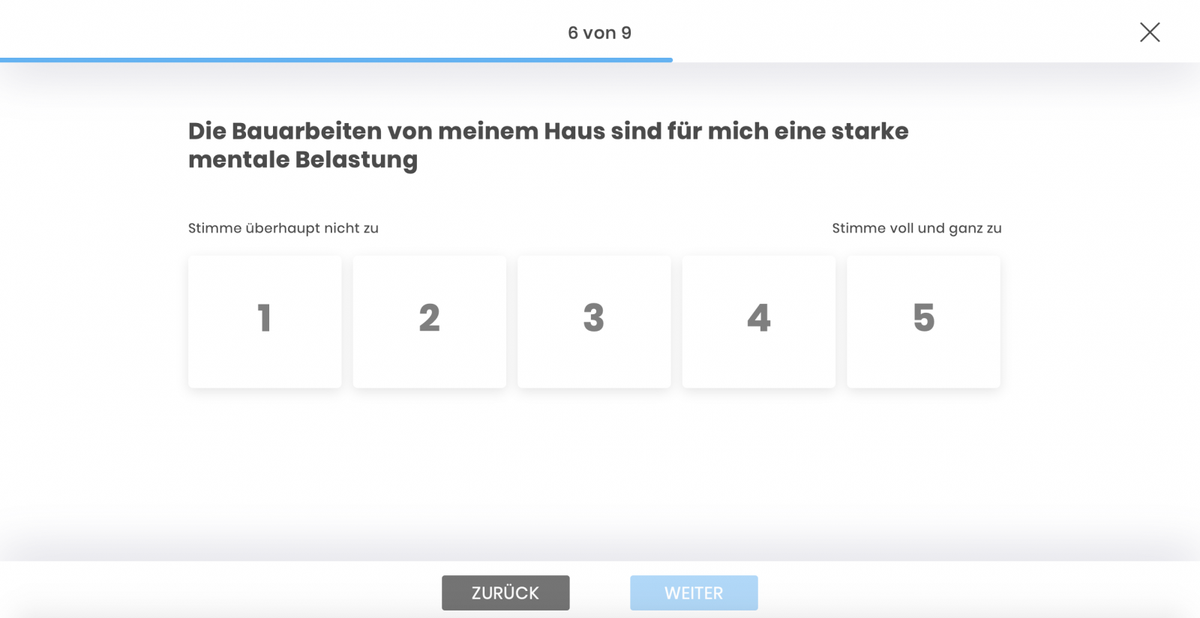
Wie viele Stufen sollte eine Ratingskala haben?
Fünf bis sieben Stufen sind die gängige Empfehlung. Die GESIS Survey Guidelines fassen die Forschungslage so zusammen, dass „eine optimale Messung in Bezug auf die Reliabilität, Validität und den Differenzierungsgrad mit fünf bis sieben Kategorien erreicht werden kann“, und dass die Befragten selbst diesen Bereich bevorzugen (Menold und Bogner 2015, GESIS Survey Guidelines).
Abgeschlossen ist die Sache damit nicht. Dieselbe Handreichung nennt neuere Arbeiten, in denen die Messqualität mit der Zahl der Kategorien weiter steigt, getestet bis 10, 11 und sogar 100 Stufen. Durchgesetzt hat sich die Faustregel fünf bis sieben trotzdem, und zwar aus einem praktischen Grund: Nur so viele Stufen lassen sich noch sinnvoll mit Worten beschriften.
Für deinen eigenen Fragebogen heißt das: Bleib bei fünf, wenn du jede Stufe beschriftest, und geh auf sieben, wenn du feinere Unterschiede brauchst. Unter fünf Stufen verlierst du Differenzierung. Über sieben lässt sich die Skala kaum noch in Worte fassen und genau daran hängt der Rest der Empfehlung.
Gerade oder ungerade Stufenzahl: die Frage nach der Mitte
Eine ungerade Stufenzahl hat eine Mitte, eine gerade zwingt zur Entscheidung. Beides ist vertretbar. Die Wahl hängt davon ab, ob eine mittlere Position inhaltlich überhaupt existiert: Bei „Wie zufrieden bist du?“ gibt es echte Unentschiedenheit, bei „Würdest du dieses Seminar weiterempfehlen?“ eher nicht.
Die GESIS Survey Guidelines fassen zusammen, dass die meisten Forschenden dazu raten, die Mittelkategorie anzubieten. Der Grund ist nicht Bequemlichkeit, sondern Datenqualität: Fehlt die Mitte, weichen Befragte mit tatsächlich neutraler Haltung auf eine benachbarte Stufe aus und verzerren das Ergebnis in eine Richtung, die es gar nicht gibt. Der Preis dafür ist die Tendenz zur Mitte, auf die dieser Artikel weiter unten eingeht.
Eine Besonderheit gilt für bipolare Skalen. Dort kann die Mitte zweierlei bedeuten: Indifferenz im Sinne von „weder noch“ oder Ambivalenz im Sinne von „teils, teils“. Auflösen lässt sich das nur mit einer zusätzlichen, abgesetzten Kategorie wie „Ich kann das nicht beurteilen“. Sonst bleibt nur, die Doppeldeutigkeit bei der Interpretation zu benennen. Bei unipolaren Skalen ist die Lage einfacher, weil die Mitte dort schlicht für eine mittlere Ausprägung steht und sich mit einem Wort wie „mittelmäßig“ beschriften lässt.
Achtung
„Weiß nicht“ und „keine Angabe“ sind keine Skalenstufen und gehören nicht in die Mitte. Ihr Platz ist abgesetzt am Ende der Antwortliste, in der Auswertung zählen sie als fehlender Wert. Ob du sie überhaupt anbietest, hängt laut den GESIS Survey Guidelines von Thema, Erhebungsmodus und Zielgruppe ab. Dieselbe Quelle verweist auf Untersuchungen von Sturgis und Kollegen, nach denen Befragte sonst die Mittelkategorie als Ersatz nutzen. Diese Antworten heißen dort „face saving don't knows“ und sie verändern die Verteilung spürbar.
Kostenlos Umfrage erstellen
Mit empirio.ai erstellst du in wenigen Minuten eine moderne Online-Umfrage – mit Hosting in der EU.
- Umfrage per KI
- Per Drag & Drop anpassen
- Auswertung in Echtzeit
Die Stufen beschriften: Wortlisten, die du übernehmen kannst
Beschrifte jede Stufe, nicht nur die beiden Enden. Die GESIS Survey Guidelines sprechen sich „eher für die Verwendung vollverbalisierter Ratingskalen“ aus, weil sie Reliabilität und Validität erhöhen und von den Befragten bevorzugt werden. Besonders deutlich fällt der Unterschied bei Personen mit geringer formaler Bildung aus.
Gute Stufenwörter erfüllen vier Bedingungen. Sie sind präzise, sie verteilen sich symmetrisch mit gleich vielen positiven wie negativen Stufen, sie sind allgemein verständlich und ihre Abstände wirken gleich groß. Die letzte Bedingung ist die schwierigste, denn „oft“ und „manchmal“ liegen für verschiedene Menschen unterschiedlich weit auseinander.
Genau daran hat Bernd Rohrmann 1978 empirisch gearbeitet und für mehrere Bewertungsdimensionen deutsche Abstufungen vorgeschlagen, deren Abstände möglichst gleichmäßig ausfallen. Vier davon gibt das Staatsinstitut für Schulqualität und Bildungsforschung in Bayern so wieder (ISB Bayern, Antwortformate):
- Häufigkeit: nie, selten, gelegentlich, oft, immer
- Intensität: gar nicht, wenig, mittelmäßig, überwiegend, völlig
- Wahrscheinlichkeit: keinesfalls, wahrscheinlich nicht, vielleicht, ziemlich wahrscheinlich, ganz sicher
- Bewertung: trifft gar nicht zu, trifft wenig zu, trifft teils-teils zu, trifft ziemlich zu, trifft völlig zu
Zwei Einschränkungen gehören dazu. Erstens handelt es sich laut derselben Quelle „nicht um feste Regeln, sondern nur um Anhaltspunkte für die Benennung von Antwortstufen“. Zweitens kursieren die Listen in leicht abweichenden Fassungen, weil sie meist aus zweiter Hand zitiert werden. Als Ausgangspunkt für eigene Formulierungen taugen sie trotzdem deutlich besser als frei erfundene Stufenwörter.
Tipp
Frag nach der Sache selbst statt nach Zustimmung. Frag also nicht „Ich nutze Umfragen häufig“ mit einer Zustimmungsskala, sondern „Wie häufig nutzt du Umfragen?“ mit der Häufigkeitsskala von oben. Die GESIS Survey Guidelines raten von Zustimmungsskalen ab, weil sie höhere Zustimmungsraten produzieren als Skalen, die direkt nach dem Merkmal fragen.
Ratingskala auswerten: welche Kennzahl du berichten darfst
Berichte immer zuerst die Häufigkeitsverteilung, also wie viele Personen jede Stufe gewählt haben. Diese Angabe ist auf jedem Skalenniveau zulässig, sie geht beim Zusammenfassen nicht verloren und sie zeigt Dinge, die jede einzelne Kennzahl verdeckt.
Ein Beispiel: Zwei Kurse werden auf einer Skala von 1 bis 5 bewertet und beide kommen auf einen Mittelwert von 3,0. Im ersten Kurs haben alle die 3 angekreuzt. Im zweiten hat die Hälfte eine 1 vergeben und die andere Hälfte eine 5. Derselbe Mittelwert, zwei verschiedene Lagen. Auch der Median trennt sie nicht, er liegt in beiden Fällen bei 3. Erst die Verteilung zeigt den Unterschied.
| Kennzahl | Wann sie passt | Was sie zeigt |
|---|---|---|
| Häufigkeitsverteilung | immer | Besetzung jeder einzelnen Stufe |
| Modus | immer | die am häufigsten gewählte Stufe |
| Median | bei einem Einzelitem | die mittlere Antwort |
| Mittelwert | bei einem Skalenscore | Durchschnitt über mehrere Items |
| Standardabweichung | bei einem Skalenscore | wie weit die Antworten streuen |
| Top-2-Box | für Berichte und Präsentationen | Anteil der beiden obersten Stufen |
Der Mittelwert ist damit nicht verboten, aber er braucht eine Begründung. Bei einem einzelnen Item ist der Median die vorsichtigere Wahl, weil er nur eine Reihenfolge voraussetzt. Bei einem Skalenscore aus mehreren Items zum selben Konstrukt ist der Mittelwert üblich und vertretbar, sofern die Äquidistanz im Methodenteil als Annahme benannt wird.
Für Gruppenvergleiche gilt dieselbe Zweiteilung. Einzelitems vergleichst du mit rangbasierten Verfahren, Skalenscores auch mit Verfahren, die auf Mittelwert und Streuung aufbauen. Wo die Grenze zwischen beschreibender und schließender Auswertung verläuft, ordnet unser Beitrag zur deskriptiven Statistik und Inferenzstatistik ein.
Die Top-2-Box taucht in Praxisberichten überall auf. Sie fasst die beiden zustimmendsten Stufen zu einem Prozentwert zusammen, etwa „78 Prozent sind zufrieden oder sehr zufrieden“. Das ist zulässig, kostet aber Information. Wer sie berichtet, nennt die volle Verteilung im Anhang.
Typische Fehler bei Ratingskalen
Die meisten Schwächen einer Ratingskala entstehen beim Formulieren, nicht beim Rechnen. Antworttendenzen bezeichnen in der Umfrageforschung das Phänomen, dass Befragte ihre Antworten unabhängig vom Frageinhalt in eine bestimmte Richtung verschieben. Sie treffen nicht alle. Aber bei denen, die sie treffen, gehen sie in eine berechenbare Richtung und deshalb mitteln sie sich nicht heraus.
Die vier folgenden Muster sind gut dokumentiert und in den GESIS Survey Guidelines zu Antworttendenzen zusammengefasst (Bogner und Landrock 2015). Gegen keines davon hilft eine größere Stichprobe, wohl aber ein besserer Fragebogen.
Die Tendenz zur Mitte zieht Antworten in die Skalenmitte
Manche Befragte wählen unabhängig vom Inhalt die mittleren Stufen, weil das weniger Nachdenken kostet als eine klare Festlegung. Die Folge ist eine Verteilung, die ausgewogener aussieht, als die Einstellungen tatsächlich sind. Hilfreich ist eine vollständig beschriftete Skala, weil sie das Nachdenken erleichtert. Wenn eine mittlere Position inhaltlich ausscheidet, ist eine gerade Stufenzahl die einfachste Lösung.
Die Zustimmungstendenz lässt Befragte allem zustimmen
Akquieszenz bezeichnet die Neigung, Aussagen unabhängig von ihrem Inhalt zuzustimmen, also überall „stimme zu“, „wahr“ oder „ja“ anzukreuzen. Die GESIS Survey Guidelines nennen dafür nur ein wirklich wirksames Gegenmittel, nämlich auf Zustimmungsskalen zu verzichten und stattdessen direkt nach dem Merkmal zu fragen. Wer bei Zustimmungsskalen bleibt, kann die Hälfte der Items umgekehrt formulieren. Das macht die Tendenz sichtbar und hält den Mittelwert sauber, rettet aber weder Korrelationen noch Faktorstrukturen.
Soziale Erwünschtheit schönt heikle Fragen
Bei Themen, die Befragte als sensibel empfinden, geben sie die erwartete Antwort statt der zutreffenden. Normverletzendes Verhalten wird heruntergespielt, normkonformes übertrieben. Gute Nachricht für Online-Befragungen: Die GESIS Survey Guidelines halten fest, dass diese Tendenz geringer ausfällt, wenn keine interviewende Person anwesend ist. Der Effekt verschwindet dadurch nicht. Er wird nur kleiner.
Extremantworten hängen nicht nur am Thema
Extremantworten sind das Gegenstück zur Tendenz zur Mitte, also die Neigung, unabhängig vom Inhalt die äußersten Stufen zu wählen. Messen lässt sich das als Anteil extremer Antworten über mehrere Ratingskalen hinweg. Ob dahinter ein stabiles Personenmerkmal steckt, ist in der Forschung nicht entschieden. Belegt ist dagegen, dass schriftliche und Online-Befragungen laut den GESIS Survey Guidelines weniger betroffen sind als Telefon- und persönliche Interviews.
Ein letzter, unscheinbarer Fehler betrifft die Optik. Stufen müssen optisch gleich weit auseinanderliegen, sonst fallen der inhaltliche und der sichtbare Mittelpunkt der Skala auseinander. Weitere Stellschrauben für sauberere Antworten stehen in unserem Beitrag mit Tipps für Online-Umfragen.
Fazit
Eine Ratingskala ist schnell eingebaut und genauso schnell verdorben. Fünf vollständig beschriftete Stufen, eine bewusste Entscheidung über die Mitte und eine ebenso bewusste über die Weiß-nicht-Option bringen mehr Datenqualität als jede zusätzliche befragte Person. Bei der Auswertung gilt: Die Verteilung gehört immer in den Bericht, der Mittelwert nur mit Begründung.
Wie es weitergeht
- Du willst alle Messniveaus im Zusammenhang sehen? Skalenniveau bestimmen
- Du arbeitest mit Zustimmungs-Items? Likert-Skala
- Du suchst das passende Antwortformat? Fragetypen im Fragebogen
- Du befragst dein Team zur Zufriedenheit? Mitarbeiterzufriedenheit messen
Willst du deine Skala einmal ausprobieren, bevor sie rausgeht?
Bei empirio.ai, einem Online-Umfrage-Tool aus Deutschland, legst du eine abgestufte Skala in wenigen Minuten an und siehst nach ein paar Testantworten, ob die Verteilung das hergibt, was du berichten willst.