

Twee vragenlijsten willen dezelfde informatie. De ene vraagt „Hoe oud bent u?”, de andere „In welk jaar ben je geboren?”. De antwoorden zijn niet even volledig, niet even nauwkeurig en uiteindelijk niet even bruikbaar bij de analyse.
Sociaal-demografische gegevens zijn de kenmerken van de persoon die in vrijwel elke vragenlijst voorkomen: leeftijd, geslacht, opleiding, arbeidspositie, inkomen en woonplaats. Je verzamelt ze om antwoorden per groep te vergelijken en je steekproef te plaatsen, en je kunt daarbij beter de indelingen van het CBS overnemen dan zelf iets bedenken. Aan het eind heb je zes vragen die je kunt overnemen en weet je welke je beter weglaat.
📌 In het kort
- Sociaal-demografische gegevens beschrijven de persoon, niet het onderwerp.
- Het CBS levert de indelingen die vergelijkbaar zijn met officiële cijfers.
- Religie en seksuele gerichtheid vallen onder artikel 9 van de AVG.
- Vooraan plaatsen verlaagt de respons niet (Teclaw 2012).
- Onder vijf personen per groep is anonimiteit niet houdbaar.
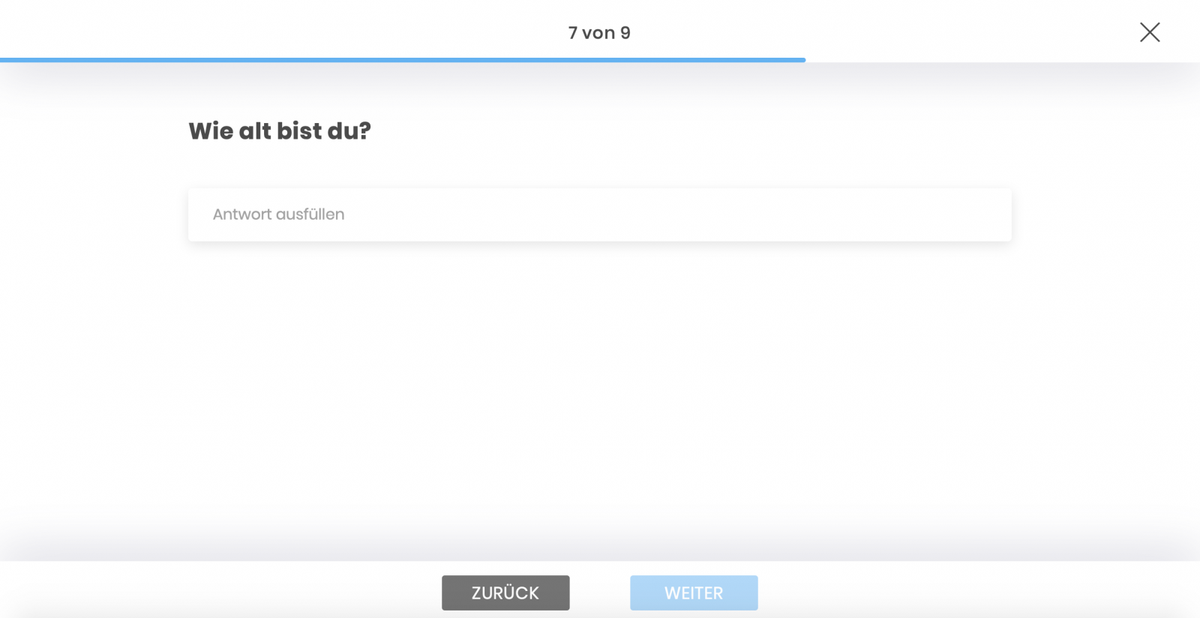
Zo ziet zo'n vraag eruit in een afgeronde vragenlijst, als gesloten keuze met vaste categorieën.
Gratis enquête maken
Met empirio.ai maak je in enkele minuten een moderne online enquête — met hosting in de EU.
- Enquête met AI
- Aanpassen met drag & drop
- Analyse in realtime
Wat zijn sociaal-demografische gegevens?
Sociaal-demografische gegevens zijn kenmerken die een respondent sociaal en demografisch plaatsen: leeftijd, geslacht, opleidingsniveau, beroep, arbeidspositie, inkomen, burgerlijke staat en woonplaats. Ze beschrijven de persoon achter de mening en niet de mening zelf.
Daar komt hun nut precies vandaan. Zonder deze gegevens heb je één gemiddelde over alle deelnemers en verder niets. Met deze gegevens kun je vragen of studenten anders antwoorden dan werkenden, of leeftijdsgroepen uiteenlopen en of je steekproef überhaupt lijkt op de groep waarover je een uitspraak wilt doen.
In de onderzoeksmethodologie heten deze kenmerken daarom achtergrondkenmerken, en ze vormen het startpunt om de representativiteit van een steekproef te beoordelen. Voor een verenigingsonderzoek klinkt dat overdreven. Voor een scriptie is het het verschil tussen een analyse en een kolom cijfers.
Deze zes kenmerken volstaan voor de meeste onderzoeken:
- Leeftijd, gevraagd als geboortejaar of als klasse.
- Geslacht, met minstens een optie om niets in te vullen.
- Hoogst voltooide opleiding, in één keuze.
- Huidige arbeidspositie, inclusief studie en pensioen.
- Netto huishoudinkomen, in klassen in plaats van bedragen.
- Woonplaats, meestal provincie of postcodegebied.
Demografisch of sociaal-demografisch: waar de grens ligt
Demografische kenmerken beschrijven de bevolkingsstructuur in enge zin: leeftijd, geslacht, burgerlijke staat en woonplaats. Sociaal-demografische kenmerken voegen de sociale positie toe: opleiding, beroep, arbeidspositie en inkomen. Elk demografisch kenmerk is dus ook sociaal-demografisch, andersom geldt dat niet.
In de praktijk worden beide termen vrijwel door elkaar gebruikt en trekt geen enkele bindende norm de grens. Als een sjabloon „demografische vragen” aankondigt, horen opleiding en beroep er meestal gewoon bij. Voor je eigen werk telt de vraag welke kenmerken je echt gaat analyseren veel zwaarder dan het onderscheid.
Een derde term duikt op in marktonderzoeksrapporten en betekent iets anders: psychografische kenmerken, dus waarden, interesses en leefstijl. Dat zijn geen gegevens over de persoon in de hier bedoelde zin maar houdingen, en ze horen in het inhoudelijke deel van je vragenlijst.
Sociaal-demografisch zegt wie iemand is. Psychografisch zegt hoe iemand denkt.
De zes sociaal-demografische vragen en hun formulering
Het Nederlandse ijkpunt voor deze vragen zijn de standaardindelingen van het Centraal Bureau voor de Statistiek. Ze bestaan opdat verschillende onderzoeken onderling vergelijkbaar blijven, en dat is precies de reden om ze over te nemen in plaats van zelf categorieën te bedenken.
Vergelijkbaarheid is dus het praktische argument. Wie het opleidingsniveau in zelfbedachte treden uitvraagt, kan de steekproef achteraf met geen enkel gepubliceerd cijfer vergelijken, en bij een scriptie is die vergelijking vaak het enige bewijs over de kwaliteit van de steekproef. De formuleringen hieronder zijn onze werkversie voor korte online vragenlijsten.
| Kenmerk | Zo vraag je het | Waar je op let |
|---|---|---|
| Leeftijd | geboortejaar in vier cijfers | klassen bouw je later, jaren komen niet terug |
| Geslacht | gesloten lijst plus optie om niets te zeggen | anders en zeg ik liever niet zijn twee dingen |
| Opleiding | hoogst voltooide opleiding, één keuze | mbo, hbo en wo apart aanbieden |
| Arbeidspositie | huidige positie, één keuze | studenten, zzp en pensioen meenemen |
| Inkomen | netto huishoudinkomen in klassen | vooraf huishouden of persoon vastleggen |
| Woonplaats | provincie of postcodegebied | het volledige adres analyseert vrijwel niemand |
Leeftijd vragen: geboortejaar of leeftijdsklasse?
Het geboortejaar is de betere uitgangsvorm, omdat je daaruit later elke gewenste indeling kunt maken. Een klasse geeft de jaren nooit terug. Wie in de vragenlijst „18 tot 25” laat aankruisen en bij de analyse merkt dat de grens bij 21 interessanter was, heeft pech.
Privacy trekt bij kleine onderzoeken de andere kant op. Een geboortejaar dat maar één keer voorkomt maakt iemand in een team van twintig meteen herkenbaar. Vuistregel: zodra een groep minder dan vijf personen bevat, is de belofte van anonimiteit niet meer houdbaar. Vraag in dat geval vanaf het begin in brede klassen.
Herkomst vragen: de nieuwe CBS-indeling
Herkomst is het kenmerk waar Nederlandse vragenlijsten het snelst verouderen. Het CBS introduceerde in februari 2022 een nieuwe indeling naar herkomst. Daarbij wordt het woord migratieachtergrond niet meer gebruikt, en de hoofdindeling westers tegenover niet-westers is vervangen door een indeling op basis van werelddelen en veelvoorkomende immigratielanden.
Twee dingen volgen daaruit voor je vragenlijst. Neem de nieuwe terminologie over als je met CBS-cijfers wilt vergelijken, want de oude termen sluiten niet meer aan. En bedenk dat gegevens over etnische afkomst onder artikel 9 van de AVG vallen: die vraag hoort niet zomaar tussen leeftijd en opleiding, maar vraagt om uitdrukkelijke toestemming met een eigen vinkje.
Opleiding vragen: houd de ladder herkenbaar
Opleiding is het kenmerk waarop zelfgemaakte vragenlijsten het vaakst misgaan. Een ladder die loopt van basisonderwijs via vmbo, havo en vwo naar mbo, hbo-bachelor, wo-bachelor en master blijft herkenbaar voor respondenten en is vergelijkbaar met gepubliceerde cijfers.
Twee toevoegingen worden makkelijk vergeten. Zet mbo, hbo en wo apart in plaats van ze samen te vegen, want dat is precies de indeling waarin Nederlandse cijfers worden gepubliceerd. En voeg een optie toe voor wie nog studeert, anders moet een derdejaars een diploma claimen dat nog niet bestaat.
Inkomen vragen: klassen in plaats van bedragen
De inkomensvraag is niet te analyseren zonder drie keuzes: netto of bruto, persoon of huishouden, maand of jaar. Ontbreekt er één, dan beantwoorden deelnemers verschillende vragen en betekent het gemiddelde niets. Een bruikbare formulering: „Wat is het netto maandinkomen van jouw huishouden, dus het bedrag na belastingen en premies?”
Klassen zijn de juiste antwoordvorm, omdat vrijwel geen analyse het exacte bedrag nodig heeft. Zes tot acht treden volstaan en de bovenste blijft open. Een optie „zeg ik liever niet” hoort erbij, anders raak je mensen kwijt die deze vraag simpelweg niet willen beantwoorden.
Waar horen sociaal-demografische vragen in de vragenlijst?
Sociaal-demografische vragen staan in de meeste vragenlijsten achteraan, en dat is een verstandige standaardkeuze. Een regel die door data wordt gedekt is het echter niet.
Vaak lees je dat deze vragen vooraan deelnemers afschrikken. Robert Teclaw, Mark C. Price en Katerine Osatuke hebben dat in 2012 in het Journal of Business and Psychology experimenteel getoetst: bij een online medewerkersonderzoek kreeg een deel de demografische vragen vooraan en een deel achteraan. De uitkomst was dat plaatsing vooraan de respons op juist die vragen verhoogde, zonder effect op de respons van de overige vragen of op hun gemiddelden.
Daaruit volgt geen nieuwe algemene regel, maar een keuze naar doel. Drie gevallen dekken vrijwel alles.
- Je moet filteren of quota halen. Dan gaan de vragen vooraan, anders vullen mensen buiten de doelgroep de hele lijst voor niets in.
- Je onderwerp ligt gevoelig. Dan helpt een lichte opening en gaan de persoonsgegevens achteraan.
- Je hebt maar een handvol kenmerken nodig. Dan maakt de plek nauwelijks uit en beslis je op leesbaarheid.
⚠️ Let op
Wie alle persoonsgegevens achteraan zet, raakt ze bij elke afhaker kwijt. Juist de kenmerken waarmee je zou kunnen beoordelen wie is afgehaakt ontbreken dan. Bij lange vragenlijsten loont het om twee of drie kernkenmerken naar voren te halen en de rest achteraan te laten.
Gratis enquête maken
Met empirio.ai maak je in enkele minuten een moderne online enquête — met hosting in de EU.
- Enquête met AI
- Aanpassen met drag & drop
- Analyse in realtime
Welke sociaal-demografische vragen de AVG beperkt
Ras of etnische afkomst, religie, gezondheid, politieke opvattingen, vakbondslidmaatschap en seksuele gerichtheid zijn bijzondere categorieën van persoonsgegevens onder artikel 9 van de AVG. Verwerking ervan is in beginsel verboden, en in een onderzoek is uitdrukkelijke toestemming met een eigen vinkje in de praktijk de enige uitzondering die telt.
Artikel 9 is precies het punt waarop veel lijstjes met demografische vragen misgaan, ook een eerdere versie van dit artikel: religie en seksuele gerichtheid stonden daar gewoon tussen leeftijd en burgerlijke staat. Juridisch is dat niet dezelfde soort vraag, en het verschil kost je in het ergste geval de hele dataverzameling.
De tweede maatstaf is minimale gegevensverwerking uit artikel 5 van de AVG. Die eist dat je je beperkt tot het noodzakelijke en levert een heel praktische toets op: schrap elk gegeven waar je geen geplande analyse bij kunt noemen. Vragen naar de volledige geboortedatum terwijl je uiteindelijk in leeftijdsklassen rapporteert is precies het geval dat de bepaling bedoelt.
Daar komt de combinatievalkuil bij. Leeftijd, geslacht en afdeling zijn los onschuldig, maar samen wijzen ze in een team van twaalf vaak precies één persoon aan. Wie anonimiteit belooft, houdt deze vragen grof en laat liever een kenmerk weg. De uitwerking staat in het artikel over het anonieme onderzoek, en de grondslagen plus een voorbeeldtekst voor de privacyverklaring staan in dat over privacy bij onderzoek.
Bij twijfel telt het standpunt van de Autoriteit Persoonsgegevens of de regeling van je onderwijsinstelling. Dit artikel vervangt geen juridisch advies.
Veelgemaakte fouten bij sociaal-demografische vragen
De vier fouten hieronder komen steeds terug in vragenlijsten van studenten, verenigingen en kleine teams. Alle vier vallen ze pas bij de analyse op, en dan is het te laat.
Ze hebben één ding gemeen: geen ervan komt voort uit slordigheid. Ze komen voort uit het schrijven van de vraag voordat duidelijk is hoe de analyse eruit gaat zien.
Verplicht veld zonder uitweg
Een gedwongen antwoord op een persoonlijke vraag levert twee reacties op en beide schaden: sommigen haken af, anderen vinken willekeurig iets aan. De tweede groep is gevaarlijker, want die antwoorden zijn niet van echte te onderscheiden. Elke vraag over de persoon krijgt daarom de optie „zeg ik liever niet”, ook als de vraag verplicht is.
Tools als Google Forms, SurveyMonkey en empirio.ai laten je afzonderlijke vragen verplicht stellen. De uitwijkoptie ontstaat daardoor niet: die moet je zelf als antwoordmogelijkheid toevoegen.
Leeftijdsklassen die overlappen of gaten laten
„18 tot 25, 25 tot 35, 35 tot 45” is de klassieker: wie 25 is kan twee keer aankruisen. Een gat komt net zo vaak voor, meestal als er na „tot 65” niets meer volgt. Beide fouten ontstaan door snel typen en zijn in twee minuten verholpen als je de grenzen één keer hardop doorloopt.
Antwoordlijsten die niet bij de doelgroep passen
Een lijst met arbeidsposities zonder „student” is waardeloos voor een onderzoek onder studenten. Hetzelfde geldt voor opleidingslijsten zonder „nog studerend” en voor inkomensklassen die beginnen boven wat je respondenten verdienen. Toets elke lijst aan de mensen die de link daadwerkelijk krijgen.
Zelfbedachte categorieën in plaats van CBS-indelingen
Wie eigen opleidings- of inkomenstreden verzint, kan de steekproef achteraf met geen enkel gepubliceerd cijfer vergelijken. Daarmee vervalt de eenvoudigste uitspraak over de kwaliteit van de steekproef, en juist daar vraagt een begeleider naar. De CBS-indelingen overnemen kost vijf minuten en voorkomt dit probleem volledig.
Conclusie
Sociaal-demografische vragen zijn het deel van de vragenlijst waar creativiteit het minst oplevert. Neem de gangbare categorieën over, vraag leeftijd als geboortejaar, geef elke persoonlijke vraag een uitwijkoptie en schrap alles waarvoor je geen analyse hebt gepland.
Elk persoonsgegeven dat je verzamelt, moet je daarna ook beschermen.
Hoe je verdergaat
- Ben je de vragenlijst aan het bouwen? Een vragenlijst maken: aanpak en opbouw
- Twijfel je over de vraagtypen? Vraagtypen en antwoordvormen op een rij
- Vraag je je af welk meetniveau leeftijd heeft? Meetniveaus eenvoudig uitgelegd
Een vragenlijst bouwen zonder de standaardvragen elke keer opnieuw te typen?
empirio.ai, een online enquêtetool uit Duitsland, verwerkt de antwoorden in de EU en laat je per vraag verplichte velden en uitwijkopties instellen.